发布日期:2026-10-10 06:53:24
先看一个现象:越来越多的人,正在把问题抛给 DeepSeek——“宝宝奶粉怎么选”、“新能源车到底能不能买”。答案几秒钟就出来,引用来源一条条列在下面,比搜索引擎的十条蓝色链接更像一份已经替你整理过、直接给出结论的建议。
这意味着内容行业的入口正在变化:过去,内容的价值很大程度取决于“能不能被搜索引擎收录、排到前面”;现在,内容还要回答另一个问题——“能不能被 AI 发现、读取并采用,最终进入答案?” 。被引用,是内容进入 AI 答案最可观测、也最可验证的信号之一。
内容多了一个新读者——AI,它不靠点击投票,靠“引用”投票。
但紧接着是两个问题:AI 到底引用什么?它凭什么这样引用?
我们花了两年时间持续跟踪 DeepSeek 在奶粉和新能源车两个行业的引用记录,结合公开资料观察它背后的检索与生成机制,也将尝试通过具体的数据分析解读两件事——答案里的信息源怎么变了,答案的生成机制怎么变了,以及这两件事如何共同影响内容的价值规则。
01 信息源演变:答案里的“食材”在换血
基于闻道网络 GEO 系统持续监测数据,我们按观察日持续采集 DeepSeek 回答中的实际引用来源,并按来源类型、域名和模型模式进行归类统计。本文讨论的是引用结构的变化,不等同于互联网整体内容供给的变化,也不能单独用于证明某一机制导致了某一来源份额的变化。
第一层:结构呈现出相对稳定的分层特征。两个行业都能看到清晰的来源分层——媒体是重要基础盘,垂直与专业内容也占据显著位置:
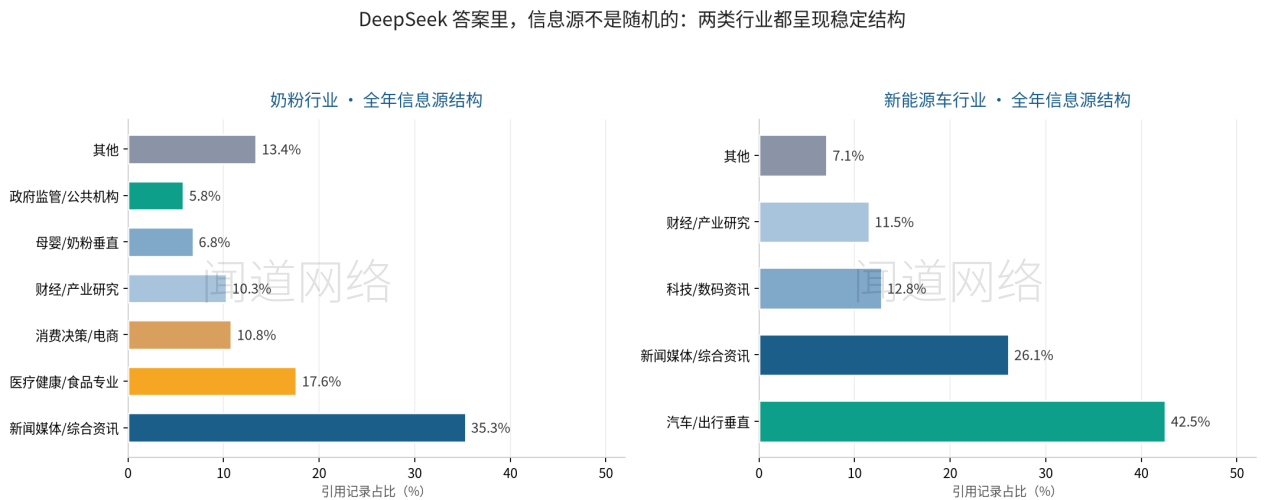
奶粉行业里,新闻媒体/综合资讯占约 35%,医疗健康/食品专业占约 18%,消费决策/电商占约 11%、财经产业研究占约 10%;新能源车行业里,汽车/出行垂直占 43%,新闻媒体占 26%,科技/数码资讯占 13%。值得注意的是,两个行业的榜首都不是泛咨询,而是“懂行”的内容。
具体到域名,“懂行优先”的集中度更直观。奶粉行业被引用最多的母婴垂直站是奶粉智库(占母婴类引用的 28.9%),其后是 TOM 母婴、摇篮网、宝宝树;头部媒体以新京报、网易、搜狐、界面为代表。新能源车行业被引用最多的是汽车之家(占汽车类引用的 25%)、易车(17%)、懂车帝(11%);科技类里中关村在线一家就占 59%。
第二层:份额在流动,方向很明确,奶粉走向专业与严谨,汽车走向资讯的时效性。
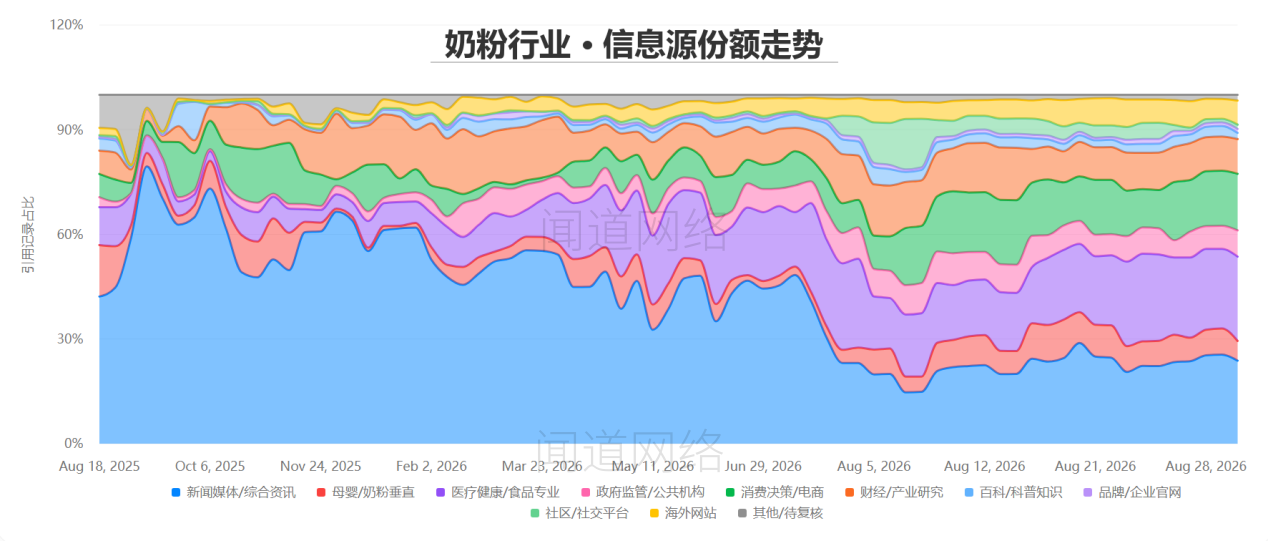
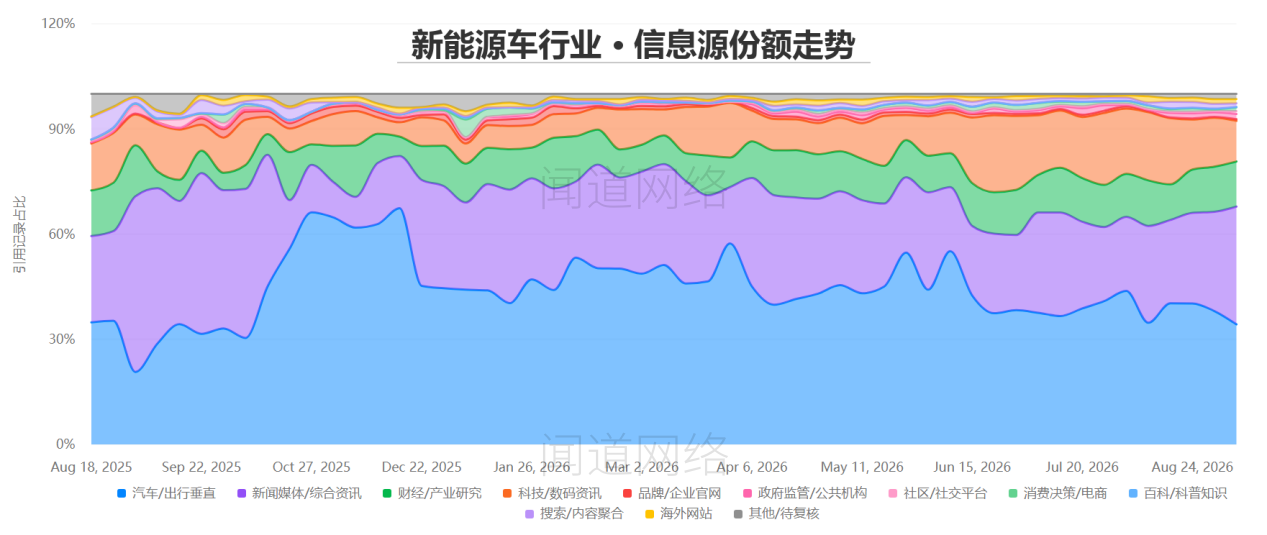
奶粉行业:新闻媒体/综合资讯从约 42% 降到约 24%;医疗健康/食品专业从约 11% 升到约 24%;政府监管/公共机构从约 3% 升到约 8%。新能源车行业:汽车/出行垂直全年稳定居首(首观察日 34.8%、末观察日 34.2%);新闻媒体/综合资讯从约 25% 升到约 34%;科技/数码资讯从约 13% 降到约 12%(2026 年 6 月一度冲高至约 22% 后回落)。
为什么会这样?仅凭引用数据不能给出唯一答案。
一个值得关注的解释是:用户交给 AI 的问题正在变得更具体——选品、比价、安全、参数。“这款奶粉适不适合肠胃敏感的宝宝”,单纯的泛资讯往往不足以支撑回答,模型需要寻找更专业、可验证的证据。与此同时,模型版本、检索策略、Prompt 结构和索引覆盖的变化,也可能影响来源结构。我们看到的,更可能是用户问题变化与模型机制变化共同作用后的结果。
这里要说明边界:这组数据说明“被引用的结构在变”,但不说明媒体内容没用了——媒体仍是最大来源之一,只是从“绝对主角”变成了“基础盘”。
到这里,第一个问题“AI 引用什么”有了答案。但更关键的是第二个问题:它凭什么这样引用?这就要拆开答案的生成机制。
02 模型机制变化:答案的“做法”在升级
对于需要外部信息、尤其是带引用的 AI 回答而言,答案越来越多地由“检索 + 推理”共同完成:模型寻找外部信息,再据此组织答案。过去一年值得关注的变化,是模型开始更深地参与“找什么、读什么、是否继续查”的过程。
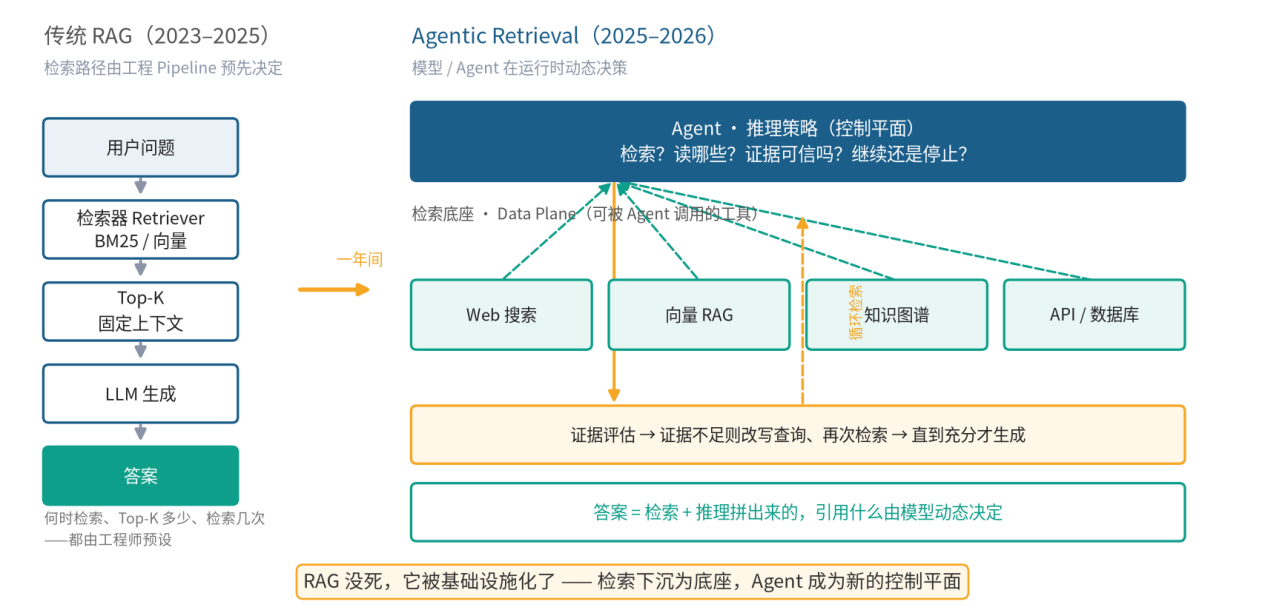
传统 RAG(2023—2025):工程师预设的流水线。流程是固定的:用户提问,检索器召回,截取 Top-K 上下文,模型生成。何时检索、检索几次、Top-K 取多少、证据可不可信——这些关键决策都写死在工程管道里。内容能不能进答案,很大程度取决于“工程师当初怎么配的检索策略”,而不是内容本身。
Agentic Retrieval(2025—2026):模型自己当厨师。检索变成模型运行时的动态决策:要不要检索、检索什么、读哪些结果、证据可不可信、证据不够要不要再查一轮。模型像一位有判断力的厨师——自己决定去哪进货、挑哪些料、火候不够就再炖一轮。
这不是个别产品的动作,而是全行业的迁移。公开口径里:OpenAI 的 Deep Research 是“规划并执行多步骤研究”;Google Gemini 迭代式地“搜索、读、找缺口、再搜”;Perplexity 把检索写成可并行执行的“搜索程序”(Search as Code);DeepSeek V4 把上下文扩到 100 万 token,并强化 Agent 与工具使用能力。方向一致:检索从“固定管道”变成“模型可编排的工具”。
这个变化落到内容生产上,意味着三件事:
第一,内容更要“经得起拆”。模型会拆解问题、对比多来源、验证证据。观点堆砌、缺少结构的软文不利于被提取和交叉验证;清晰的标题、要点、数据与清单,更方便模型识别、引用和组合。
第二,被引用不等于有效。证据链变长了:被召回,不等于被读取;被读取,不等于被采纳;被采纳,也不一定形成品牌语境。一条内容进了参考列表只是第一步,品牌有没有在相关语境里被有效提及,才是真正的“有效”。
第三,不同模式看到的答案不一样。“快速模式”和“专家模式”像两位阅读习惯不同的读者,引用范围并不重合:
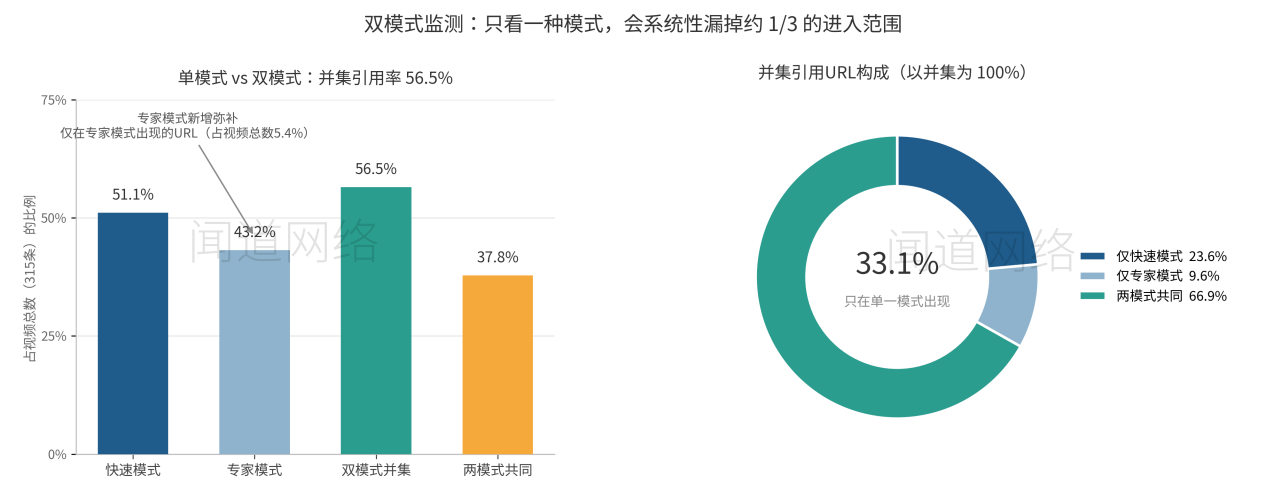
多个行业的视频中,双模式并集引用率为 56.5%;但 33.1% 的引用 URL 只在单一模式出现。只看一种模式,会系统性漏掉约 1/3 的进入范围——这也是为什么监测内容可见性,不能只看单一模式。
结尾:把两条线收回来
回到开头的两个问题。AI 引用什么,取决于信息源的结构与质量(食材);AI 怎样决定引用,取决于模型机制怎么决策(做法)。两个问题其实是一件事的两面:AI 正在从“搬运工”变成“有判断力的读者”——它自己挑食材,自己定做法。
对做内容的人来说,判断策略该不该变,看三件事:
1.信息源结构:你所在行业,AI 引用的是媒体、垂直还是官方?结构是否在变?
2.内容结构化:你的内容能不能被模型快速拆出要点、证据、清单?
3.模式稳健性:换一种模型模式,你的内容还在答案里吗?
当信息源结构、内容结构和模型模式同时发生变化时,品牌面对的就不再只是一个新的流量入口,而是一套正在形成的新内容分发机制。搜索时代研究的是:怎样被找到;AI 时代还要多回答一个问题:为什么模型愿意采用你的内容。


 Mail: cong.song@winndoo.com
扫码关注

